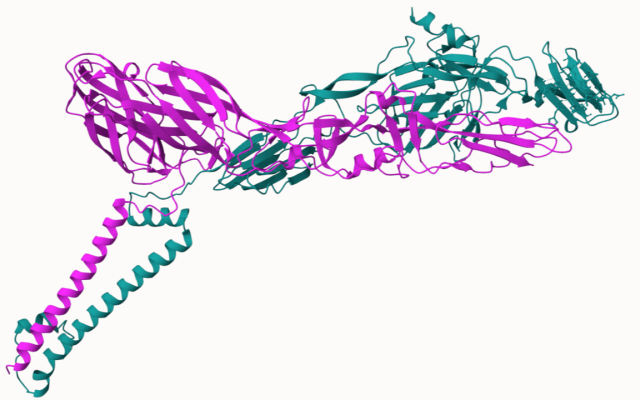
Les chercheurs et les développeurs de médicaments peuvent désormais étudier les virus présentant les risques les plus importants pour la santé publique à une échelle et à un rythme accrus. Des modèles illustrant les interactions entre les protéines virales sont désormais librement accessibles pour 2 800 virus infectant l’homme et leurs apparentés, contre seulement une poignée auparavant, ainsi que les toutes premières structures 3D prédites de près de 7 800 protéines virales. Le SIB a participé à la sélection des virus analysés par l’IA AlphaFold, a fourni des données protéiques uniques pour 699 virus et a assuré le contrôle qualité des interactions prédites pour ces protéines. Ce travail est le fruit d’une collaboration internationale réunissant l’EMBL-EBI, NVIDIA, Google DeepMind, l’Université nationale de Séoul et l’Université de Glasgow. Il vient renforcer les contributions du SIB au projet AlphaFold, lauréat du prix Nobel, ainsi qu’à la lutte contre les maladies infectieuses.
AlphaFold : une IA lauréate du prix Nobel développée à l'aide des ressources du SIB
AlphaFold a permis de calculer rapidement la structure 3D d’une protéine à partir de sa séquence d’acides aminés, au lieu de recourir à des procédures expérimentales longues et coûteuses. Des modèles ultérieurs ont étendu cette capacité à la prédiction des interactions entre les protéines et d’autres molécules.
Le développement d’AlphaFold – récompensé par le prix Nobel de chimie 2024 – s’est appuyé sur trois ressources ouvertes et initiatives développées et co-développées par des scientifiques du SIB. UniProt a fourni des données d’entraînement ouvertes de haute qualité ainsi que des connaissances sur des millions de protéines, tandis que le concours CASP et la ressource CAMEO ont respectivement confirmé l’impressionnante précision de l’IA et son applicabilité à toutes les protéines humaines.
Combler une lacune dans les données pour se préparer à une épidémie
Le développement de tests de dépistage, de vaccins et de traitements contre les virus repose sur la connaissance de la structure 3D des protéines virales et de la manière dont ces protéines interagissent entre elles. La rapidité sans précédent avec laquelle des vaccins contre le SARS-CoV-2 ont été mis au point, par exemple, n’a été possible que grâce à des décennies de recherche sur des virus similaires menées avant la pandémie.
AlphaFold : une IA lauréate du prix Nobel développée à l'aide des ressources du SIB
AlphaFold a permis de calculer rapidement la structure 3D d’une protéine à partir de sa séquence d’acides aminés, au lieu de recourir à des procédures expérimentales longues et coûteuses. Des modèles ultérieurs ont étendu cette capacité à la prédiction des interactions entre les protéines et d’autres molécules.
Le développement d’AlphaFold – récompensé par le prix Nobel de chimie 2024 – s’est appuyé sur trois ressources ouvertes et initiatives développées et co-développées par des scientifiques du SIB. UniProt a fourni des données d’entraînement ouvertes de haute qualité ainsi que des connaissances sur des millions de protéines, tandis que le concours CASP et la ressource CAMEO ont respectivement confirmé l’impressionnante précision de l’IA et son applicabilité à toutes les protéines humaines.
Ces connaissances font défaut pour 80 % des virus. Cela s’explique par le coût et le temps nécessaires aux études expérimentales, ainsi quepar le fait que certains virus sont impossibles à cultiver en laboratoire.
Le modèle d’IA AlphaFold (voir encadré) surmonte cette limite en prédisant avec précision les structures protéiques en 3D à partir de séquences d’acides aminés. Une collaboration internationale, associant les secteurs public et privé, a désormais utilisé AlphaFold pour prédire les interactions entre des paires de protéines virales chez 2 800 virus, tous issus de familles connues pour infecter l’homme.
Cette collaboration – à laquelle participent l’Institut européen de bioinformatique du Laboratoire européen de biologie moléculaire (EMBL-EBI), NVIDIA, Google DeepMind, l’Université nationale de Séoul, l’Université de Glasgow, le SIB, la Coalition pour les innovations en matière de préparation aux épidémies (CEPI) et l’Université Sungkyunkwan – a réuni des compétences en biologie virale, en biologie structurale, en biocuration, en gestion et analyse des données, ainsi qu’en IA, sans oublier la puissance de calcul nécessaire pour réaliser des prédictions à cette échelle.
Les contributions du SIB ont consisté à :
- la sélection conjointe, avec l’université de Glasgow, de l’ensemble des virus de référence analysés;
- la fourniture de données uniques sur les polyprotéines – des protéines précurseurs complexes produites par 47 % des virus infectant l’homme, notamment le virus Zika, le virus de la dengue et le poliovirus ;
- la validation de la plausibilité des prédictions structurelles d’AlphaFold pour ces protéines, en s’appuyant sur les connaissances exhaustives et validées en biologie virale accumulées dans la ressource ViralZone du SIB.
Cela a permis à AlphaFold de modéliser, pour la première fois, les structures 3D et les interactions probables de près de 7 800 protéines virales dérivées de polyprotéines (voir plus bas).
Toutes ces données ont été rendues publiques aujourd’hui dans la base de données AlphaFold, parallèlement à une réunion de l’Assemblée générale des Nations unies sur la prévention, la préparation et la réponse aux pandémies, qui se tient cette semaine à New York. Une première analyse met déjà en évidence des types d’interactions entre protéines virales jusqu’alors inconnus, ce qui a des implications pour la recherche thérapeutique et pour l’utilisation des protéines virales en tant qu’outils biotechnologiques.
Ces travaux s’inscrivent dans la mission du SIB, qui consiste à repousser les limites de la science des données grâce à une connaissance approfondie des données biologiques, à fournir aux chercheurs et aux cliniciens des ressources exceptionnelles, et à générer des connaissances permettant l’innovation pour un avenir meilleur.
Cet ensemble considérablement élargi de données en libre accès sur les protéines virales donne aux chercheurs une longueur d'avance pour mettre au point des solutions de santé publique bien avant que nous ne soyons confrontés à une nouvelle menace épidémique ou pandémique.
Génération de données fondamentales sur les virus ayant une incidence sur la santé humaine
Les virus présentent une diversité exceptionnelle, ce qui rend leur étude particulièrement complexe. Les polyprotéines ajoutent encore à cette complexité. Ces longues chaînes d’acides aminés sont clivées en différentes protéines actives – dont les séquences précises sont extrêmement difficiles à déterminer. En effet, les différents virus ont développé des mécanismes de clivage de leurs polyprotéines totalement différents, ce qui signifie qu’il n’existe aucun indice génétique commun permettant d’identifier l’emplacement de ces clivages.
Les scientifiques du SIB ont été les premiers à cartographier ces sites de clivage dans les polyprotéines virales. Les sites probables ont été identifiés grâce à un processus semi-automatisé combinant des outils informatiques, des revues approfondies de la littérature et une expertise pointue en biologie virale. La précision des sites prédits a ensuite été confirmée par une modélisation structurelle, qui a permis de vérifier si les protéines clivées ainsi obtenues étaient biologiquement plausibles.
Ces travaux, achevés en mai de cette année, ont fourni les premières données fiables sur les séquences protéiques de 7 783 protéines actives issues de polyprotéines présentes dans 699 virus, tous appartenant à des familles connues pour infecter l’homme. Ils s’inscrivaient dans le cadre d’un projet du Pathogen Data Network, co-coordonné par le SIB et soutenu par les National Institutes of Health (NIH) des États-Unis.
Mettre les nouvelles connaissances sur les virus à la disposition des chercheurs et de l'IA en libre accès
La complexité des polyprotéines virales a empêché l’intégration intégrale de ces nouvelles informations dans les ressources ouvertes de données biologiques. Les scientifiques du SIB ont donc créé une nouvelle norme d’annotation pour les polyprotéines, permettant l’intégration de données de clivage compatibles avec l’IA dans la ressource ViralZone du SIB. Ces données ouvertes et validées permettront d’accélérer la recherche sur les virus présentant un intérêt pour la santé publique. Elles constituent également un ensemble de données d’apprentissage fiable à partir duquel les modèles d’IA pourraient s’entraîner à prédire les sites de clivage d’autres virus.
L’équipe prévoit en outre de collaborer avec d’autres ressources de données biologiques ouvertes, tant spécifiques à certains agents pathogènes que généralistes, notamment UniProt et NCBI RefSeq, afin d’y intégrer ces informations de la même manière.
Les données et l'expertise du SIB au service d'une IA fiable pour les sciences de la vie
Au-delà de la caractérisation des protéines virales dans le cadre de ces travaux, la mise à disposition par le SIB de données de haute qualité et de son expertise en bioinformatique contribue à la fiabilité des systèmes d'IA dans un large éventail d'applications liées à la santé et à la biodiversité – qu'il s'agisse d'identifier les mécanismes du cancer, d'orienter les traitements des patients ou d'éclairer les actions en faveur de la protection de l'environnement.
En savoir plus sur les contributions du SIB à une IA digne de confiance
Reference(s)
Image : Structure de deux protéines en interaction issues de la polyprotéine du virus Ross River. Crédit : base de données AlphaFold